Masz strategię, kod się kompiluje, a tester pokazuje zielony wynik. Wszystko wygląda dobrze do chwili, gdy zaglądasz w pojedynczą transakcję. Na jednej świecy cena dotknęła zarówno stop lossa, jak i take profitu. Tester zapisał zysk. Tylko skąd wie, który poziom rynek odwiedził najpierw?
SL i TP w jednej świecy to sytuacja, w której te same dane mogą pasować do dwóch różnych wyników transakcji. Nie dlatego, że cena zrobiła coś niemożliwego. Dlatego, że świeca nie zapisuje całej kolejności ruchów.
W tekście o vibe codingu pokazywałem możliwości i pułapki tworzenia kodu z AI. Tutaj schodzę poziom niżej. Program może bezbłędnie wykonywać polecenia, a mimo to odpowiadać na inne pytanie, niż Ci się wydaje. Zamiast „ile zarobiłbym na rynku?” oblicza „ile zarobiłbym przy takich zasadach symulacji?”.
Zielony wynik w testerze jeszcze nie znaczy, że tę transakcję dało się tak wykonać. Pokażę to najpierw na prostych liczbach, a potem na wykonanym porównaniu 120 transakcji na historycznych danych BTC.
Jedna świeca, a wynik od −1R do +2R
Przyjmuję pozycję długą otwartą przed badaną świecą. Wejście wyniosło 100, aktywny SL jest na 99, a aktywny TP na 102. Zlecenia zamykają całą pozycję; wykonanie jednego anuluje drugie. Na razie pomijam koszty, luki i poślizg.
Ryzyko cenowe wynosi 1 na jednostkę instrumentu. To moje 1R. Zysk 2 oznacza więc +2R, a strata 1 oznacza −1R. Nie należy mylić R z procentem kapitału ani z dźwignią.
| Parametr świecy | Wartość |
|---|---|
| Otwarcie — O | 100 |
| Maksimum — H | 103 |
| Minimum — L | 98 |
| Zamknięcie — C | 101 |
Z tymi wartościami zgodny jest zarówno przebieg 100 → 103 → 98 → 101, jak i 100 → 98 → 103 → 101.
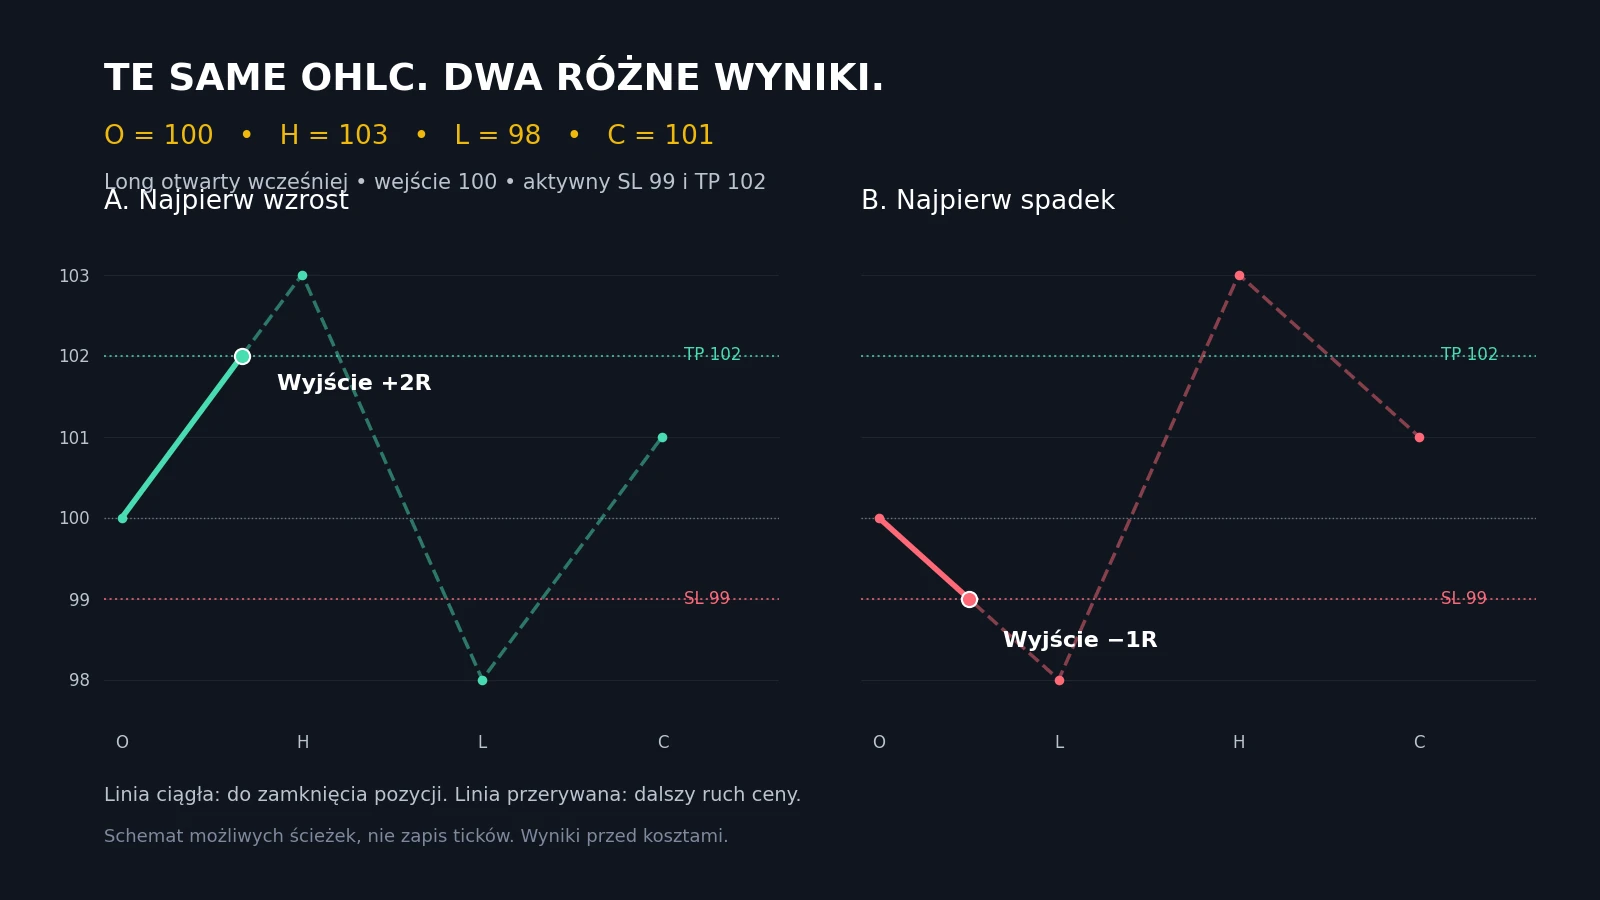
W pierwszym wariancie cena po drodze osiąga 102. Zamykam pozycję na TP i mam +2R. Późniejszy spadek do 98 już mnie nie dotyczy. W drugim wariancie najpierw osiąga 99. Mam −1R, a późniejszy wzrost do 103 nie zamienia tej straty w zysk.
Różnica wynosi 3R przy identycznych OHLC. To nie jest kosmetyka. Jeśli ryzykujesz 100 zł na transakcję, mówimy o różnicy między +200 zł a −100 zł przed kosztami.
Świeca mówi, jakie było maksimum i minimum. Nie mówi, które pojawiło się wcześniej, ile razy cena zawracała i czy Twoje zlecenie mogło zostać wtedy wykonane. Gdy oba poziomy mieszczą się w jej zakresie, tester potrzebuje dodatkowych danych albo jawnej reguły rozstrzygania.
Co TradingView zakłada wewnątrz historycznej świecy?
Według dokumentacji emulator TradingView domyślnie wybiera ścieżkę na podstawie odległości otwarcia od ekstremów. Gdy O leży bliżej H, przyjmuje O → H → L → C. Gdy O leży bliżej L, przyjmuje O → L → H → C. To model ruchu, a nie zapis transakcji z giełdy.
W naszym przykładzie odległość od otwarcia do minimum to 2, a do maksimum 3. Taka reguła wskazuje więc najpierw spadek i SL. Działa to przy założeniu, że pozycja i oba zlecenia były już aktywne.
Przy luce między świecami emulator może wykonać zlecenie cenowe po otwarciu kolejnej świecy zamiast dokładnie po wskazanym poziomie. Samo ustawienie SL nie gwarantuje więc straty równej planowanemu 1R. Źródło tych reguł to dokumentacja strategii TradingView.
Dlatego rozbieżność „backtest TradingView a rzeczywistość” zaczynam sprawdzać od pojedynczych zleceń. Jaki był typ zlecenia? Kiedy zaczęło obowiązywać? Które dane pozwalały ustalić kolejność? Sam bilans całej strategii tego nie wyjaśni.
Bar Magnifier TradingView: ważna zmiana nazwy
W starszych poradnikach znajdziesz pole „Using bar magnifier”. W dokumentacji sprawdzonej 26 października 2026 r. funkcję zastępuje menu „Bar detalization”, a większą szczegółowość wybiera się opcją „High”. Parametr Pine Script nadal nazywa się use_bar_magnifier. Zmianę interfejsu opisano w informacjach o wydaniu z lipca 2026 r..
Mechanizm korzysta z OHLC niższego interwału, gdy te dane są dostępne. Zamiast jednego dużego pudełka dostajesz kilka mniejszych. Nadal jednak są to pudełka: pojedyncza niższa świeca też może objąć SL i TP.
Nie zakładam też, że M15 automatycznie oznacza analizę M1. Tabela w starszej stronie pomocy Bar Magnifier wskazuje dla M15 interwał wewnętrzny 2 minuty. Opisany niżej własny test M1 nie jest więc kopią trybu Bar Magnifier. To celowe porównanie dwóch rozdzielczości na jednym zbiorze danych.
Istotny jest również zakres historii. Dokumentacja podaje limit 200 000 świec niższego interwału; starszy fragment testu może pozostać bez takiego pokrycia. Samo włączenie opcji nie dowodzi, że każda transakcja została przeliczona na dokładniejszych danych.
Wykonany test: te same 120 wejść, M15 kontra M1
Do sprawdzenia problemu przygotowałem prosty skrypt wykonania zleceń w Pythonie. Wersja silnika: 1.0.0, środowisko: Python 3.12.14, data uruchomienia: 26 października 2026 r.
Porównanie wykonałem własnym skryptem na rzeczywistych danych historycznych. To nie jest raport z TradingView ani wierna kopia całego emulatora tej platformy. Badam konkretny problem: jak wynik tych samych wejść zależy od szczegółowości danych i reguł wykonania.
Użyłem minutowych świec BTCUSDT z rynku spot Binance, od 20 października 2025 r. 00:00 UTC do 24 października 2025 r. 23:59 UTC. Zbiór zawiera 7200 kolejnych świec M1, bez brakujących minut i duplikatów. Z niego zbudowałem 480 świec M15. Dane pochodzą z publicznego archiwum opisanego w dokumentacji Binance Public Data.
Reguły ustaliłem przed pierwszym uruchomieniem:
- Jedno wejście long na początku każdej pełnej godziny UTC, po cenie otwarcia.
- Stała wielkość: 1 BTC, bez składania zysków i bez dźwigni.
- SL 0,2% poniżej ceny referencyjnej wejścia, TP 0,4% powyżej.
- Oba zlecenia aktywne od wejścia; pierwsze wykonane zamyka całość i anuluje drugie.
- Jeżeli nie ma SL ani TP, zamknięcie po cenie otwarcia minuty hh:30.
- Wejścia są takie same we wszystkich wariantach. Nie dopasowuję parametrów po obejrzeniu wyników.
To mechaniczna strategia testowa do badania wykonania zleceń. Nie jest moim setupem tradingowym ani propozycją handlu co godzinę przez całą dobę. Stała wielkość pozycji ułatwia porównanie; nie jest rekomendacją zarządzania kapitałem.
W podstawowym wariancie M15 użyłem opisanej reguły „bliższe ekstremum najpierw”. W wariancie M1 stosowałem tę samą regułę do kolejnych minut. Przy równej odległości skrypt wybiera minimum najpierw — to jawna reguła mojego silnika, nie deklaracja zachowania TradingView. Dwa dodatkowe warianty na M15 przyznają pierwszeństwo SL albo TP, gdy zakres jednej świecy obejmuje oba poziomy.
| Wariant bez kosztów | TP / SL / czas | Suma wyników w R |
|---|---|---|
| M15, bliższe ekstremum najpierw | 15 / 59 / 46 | −10,49R |
| M1, bliższe ekstremum najpierw | 15 / 59 / 46 | −10,49R |
| M15, SL najpierw przy kolizji | 15 / 59 / 46 | −10,49R |
| M15, TP najpierw przy kolizji | 16 / 58 / 46 | −7,49R |
Każdy wiersz obejmuje 120 transakcji. „Czas” oznacza wyjście po 30 minutach, które może przynieść zysk lub stratę mniejsze od docelowego TP/SL. Suma R nie jest procentową stopą zwrotu rachunku. Każdy wynik dzielę przez początkowe ryzyko cenowe danej transakcji: 0,2% ceny referencyjnej razy 1 BTC.
Na M15 jedna transakcja trafiła na świecę obejmującą oba poziomy. Na M1 żadna analizowana przed wyjściem minuta nie obejmowała obu. Mimo większej szczegółowości nie zmienił się wynik żadnej transakcji względem podstawowego wariantu M15. Za to reguła „TP najpierw” poprawiła wynik próby o 3R.
Nie będę szukał innego tygodnia tylko po to, żeby pokazać efektowny spadek krzywej kapitału. Dokładniejszy test może pogorszyć wynik, poprawić go albo pozostawić bez zmian. W tej próbie zaszło to trzecie.
Pięć dni i mechaniczne wejścia wystarczają do pokazania różnicy między modelami wykonania. Nie wystarczają do oceny trwałej rentowności strategii ani częstości takich kolizji na innych rynkach.
Co wydarzyło się w tej jednej transakcji?
21 października 2025 r. o 15:00 UTC skrypt otworzył long po 112 170,52 USDT. SL wyniósł 111 946,17896, a TP 112 619,20208. Świeca M15 miała maksimum 112 925,91 i minimum 111 716,91. Oba poziomy zmieściły się więc w jej zakresie.
Dane M1 rozdzieliły te zdarzenia: minuta zaczynająca się o 15:02 UTC osiągnęła SL, a pierwsza minuta osiągająca TP zaczęła się dopiero o 15:07 UTC. Pozycja była już zamknięta ze stratą. Dokładnej sekundy wykonania z tych danych nie znam, ale kolejność między tymi minutami jest jasna.
W tym przypadku prosta reguła M15 wskazała poprawną kolejność wyjścia. Arbitralne przyznanie pierwszeństwa TP zapisałoby zysk po ruchu, którego ta pozycja już nie doczekała.
Prowizja i poślizg: osobny test, osobna przyczyna różnicy
Następnie zostawiłem wykonanie na M1 i osobno zmieniałem koszty. Prowizja w tym eksperymencie to 0,05% wartości każdej strony transakcji, a poślizg to 0,01% ceny, nie jeden tick i nie 0,01 USDT. To przyjęte parametry testu, nie cennik giełdy.
Poślizg pogarsza cenę rynkowego wejścia oraz wyjścia przez SL lub upływ czasu. Nie doliczam go do TP realizowanego jako limit. Zamrażam pierwotne poziomy SL i TP oraz mianownik R, żeby oddzielić koszt wykonania od zmiany reguł strategii. Prowizję liczę od faktycznych cen symulowanych wykonań.
| Wariant M1 | Suma wyników w R |
|---|---|
| Bez prowizji i poślizgu | −10,49R |
| Tylko prowizja 0,05% za stronę | −70,48R |
| Tylko poślizg 0,01% na wykonaniach rynkowych | −21,73R |
| Prowizja i poślizg razem | −81,73R |
To duże różnice, ale przy SL równym 0,2% ceny koszt około 0,1% wartości pozycji w obie strony pochłania około pół R. Sto dwadzieścia transakcji daje około 60R samej prowizji. Tu nie potrzeba żadnej tajemniczej awarii testera.
W TradingView parametr slippage podaje się w tickach i dotyczy zleceń rynkowych oraz stop. Nie przepisuj do niego bez przeliczenia procentu z tego eksperymentu. Ustawienia prowizji i wykonania limitów opisuje dokumentacja właściwości strategii.
SL obecny w kodzie nie zawsze oznacza SL aktywny na rynku
Osobno sprawdziłem wariant, w którym pozycja jest otwierana jak wcześniej, ale SL i TP zaczynają obowiązywać dopiero 15 minut później. Wejścia, ceny referencyjne i wyjście czasowe pozostają takie same. Pierwsze 15 minut nie ma ochrony, a po aktywacji skrypt uwzględnia również sytuację, w której otwarcie znajduje się już poza poziomem zlecenia.
Bez kosztów wynik zmienił się z −10,49R do −22,32R. Liczba wyjść wyniosła 13 przez TP, 56 przez SL i 51 przez czas. To test opóźnienia aktywacji, a nie kolejny poziom dokładności danych.
Nie wyciągam z niego wniosku, że opóźnienie zawsze pogarsza rezultat. Pokazuje natomiast, że moment utworzenia zleceń jest częścią strategii. Gdy kod wystawia zabezpieczenie dopiero przy następnym przeliczeniu, nie wolno przypisywać mu wykonania na wcześniejszym ruchu.
W Pine znaczenie mają między innymi calc_on_order_fills, process_orders_on_close oraz ustawienia przeliczania skryptu. Zlecenie utworzone po zamknięciu świecy nie może korzystać z jej wcześniejszego minimum lub maksimum. Z kolei samo calc_on_every_tick nie odzyskuje historycznych ticków.
Czego ten test nadal nie odtwarza?
M1 pozwoliło ustalić kolejność wyjścia w spornej transakcji. Nie zamieniło danych w zapis pełnego rynku. Własny silnik zakłada pełne wykonanie pozycji, brak kolejki zleceń i brak ograniczeń płynności. Nie modeluje osobno spreadu, opóźnienia przesłania zlecenia, częściowych wykonań ani zaokrągleń do ticka i kroku ilości.
Przy luce stop wykonuje się w nim po otwarciu świecy, jeśli cena jest już poniżej SL; analogicznie limit może otrzymać lepszą cenę otwarcia powyżej TP. Wewnątrz pojedynczej świecy obowiązuje założona ścieżka. Gdyby jedna minuta obejmowała oba poziomy, problem wróciłby na mniejszą skalę.
Na futures dochodzą kolejne rzeczy: funding, likwidacja, wymagany depozyt i rodzaj ceny uruchamiającej stop. Stop oparty na Last Price nie musi zachować się identycznie jak stop na Mark Price. Ten eksperyment używa spotowych OHLC, więc nie udaje testu tych mechanizmów.
Lepsza rozdzielczość ogranicza niepewność. Nie gwarantuje rzeczywistego wykonania. Zwłaszcza limit „dotknięty” na wykresie nie jest dowodem, że Twoja ilość przeszłaby przez kolejkę.
Jak sprawdzam własny backtest M15 w TradingView?
- Zamrażam warunki. Ten sam symbol z tej samej giełdy, standardowe świece, identyczny okres, kod, parametry i wielkość pozycji. Zapisuję również wersję Pine i datę testu.
- Porównuję szczegółowość wykonania. Zmieniam tylko Bar detalization lub odpowiadającą mu opcję Bar Magnifier w starszym interfejsie. Rejestruję, jaki niższy interwał i jaka historia były faktycznie dostępne.
- Nie zmieniam przy okazji sygnałów. Przełączenie całej strategii z M15 na M1 może zmienić wskaźniki i wejścia. To inne doświadczenie niż dokładniejsze wykonanie tych samych sygnałów M15.
- Porównuję listę transakcji. Zysk netto i obsunięcie to początek. Szukam zmienionych wejść, wyjść i czasu aktywacji, zwłaszcza świec obejmujących oba poziomy.
- Dodaję osobno koszty i opóźnienia. Nie zmieniam pięciu opcji naraz, bo wtedy nie wiem, skąd wzięła się różnica.
- Sprawdzam odporność. Jeśli niewielka zmiana założeń kasuje całą przewagę, nie zwiększam ryzyka tylko dlatego, że najładniejszy raport nadal wygląda dobrze.
Dla n transakcji, które rzeczywiście mogą zamienić −1R na +2R przy tych samych wejściach, różnica między skrajnymi rozstrzygnięciami wynosi 3nR przed kosztami. To prosta miara wrażliwości. Przy strategii, w której inne wyjście zmienia kolejne sygnały i pozycje, nie wystarczy jednak dopisać 3nR do końcowego wyniku — trzeba przeliczyć cały przebieg.
Założenie „SL zawsze najpierw” może służyć do ostrożnego wariantu testu. Nie robię z niego rekonstrukcji rynku. Tak samo jak „TP zawsze najpierw” nie staje się prawdą tylko dlatego, że poprawia statystyki.
O co poprosić AI, zanim zaufasz napisanej strategii?
Zamiast kolejnej prośby „popraw wynik” daję konkretne zadanie:
Wskaż w kodzie moment utworzenia i aktywacji wejścia, SL oraz TP. Wyjaśnij, jak test rozstrzyga sytuację, gdy jedna świeca obejmuje oba poziomy. Dodaj rejestr takich transakcji. Oddziel interwał sygnałów od szczegółowości wykonania. Pokaż, które dane historyczne są dostępne i co dzieje się przy ich braku. Porównaj te same wejścia przed i po kosztach. Nie przypisuj zlecenia do ruchu ceny sprzed jego utworzenia.
Potem sprawdzam wynik na pojedynczej transakcji z prostymi liczbami. Odpowiedź modelu AI nie zastępuje uruchomienia kodu. Model może przekonująco wyjaśnić także regułę, której program wcale nie realizuje.
W dzienniku transakcji chcę widzieć nie tylko wynik, ale również podstawę decyzji. Przy badaniu strategii dopisuję założenia wykonania. Dzięki temu mogę ustalić, czy zmienił się rynek, kod, dane czy sposób liczenia.
Dopiero na wiarygodnych statystykach ma sens kolejny krok: dobór ryzykowanego procentu kapitału. Temu służy kalkulator optymalnego stop lossa. Nie służy do wyznaczania ceny stopa. Jeżeli skuteczność i stosunek zysku do straty pochodzą z błędnie rozstrzygniętych transakcji, kalkulator zoptymalizuje błędne dane.
Mój wniosek: najpierw sprawdzam, co właściwie policzyłem
W wykonanym teście dokładniejsze dane nie pogorszyły wyniku. Potwierdziły wyjście przez SL w jednej spornej transakcji. Zmieniły jednak podstawę oceny: zamiast polegać wyłącznie na ścieżce przyjętej dla M15, mogłem wskazać wcześniejszą minutę dotknięcia SL i późniejszą minutę dotknięcia TP.
Dla mnie to więcej warte niż piękny raport bez wyjaśnienia. Zanim pytam, ile strategia zarabia, pytam, jakie zdarzenia i założenia doprowadziły do jej wyniku. Jeżeli nie potrafię tego odtworzyć, nie mam podstaw, żeby zwiększać pozycję.
FAQ
Czy ze świecy OHLC ustalę, czy najpierw był SL, czy TP?
Nie zawsze. Gdy aktywne SL i TP mieszczą się w zakresie tej samej świecy, samo OHLC zwykle nie rozstrzyga kolejności. Potrzebujesz dodatkowych danych albo jawnego założenia testera.
Czy Bar Magnifier gwarantuje poprawny backtest?
Nie. Może poprawić szczegółowość symulowanego wykonania, ale nie odtwarza automatycznie kolejki zleceń, płynności ani rzeczywistego wykonania. Nie naprawia też błędów strategii i korzystania z przyszłych informacji.
Czy dokładniejszy backtest zawsze pokazuje mniejszy zysk?
Nie. Wynik może spaść, wzrosnąć albo zostać taki sam. W opisanym porównaniu M15 i M1 wynik wszystkich 120 transakcji był taki sam przed kosztami.
Czy wystarczy przenieść strategię z M15 na M1?
Nie, jeśli celem jest zachowanie sygnałów M15. Zmiana interwału całej strategii może zmienić jej logikę. Dokładniejsze badanie wykonania i zmiana interwału sygnałów to dwa różne testy.